vMLX: Lokale AI Inference Server voor macOS
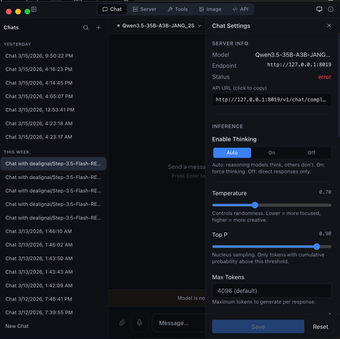
vMLX is een zelf-gehoste inference server ontworpen voor Apple Silicon, die ondersteuning biedt voor LLMs, VLMs en beeldgeneratie. De applicatie maakt gebruik van een OpenAI- en Anthropic-compatibele HTTP API, waardoor gebruikers geen derde partij API-sleutels hoeven te gebruiken. Met vMLX kunnen ontwikkelaars modellen van HuggingFace of lokale paden eenvoudig uitvoeren, waardoor een flexibele en krachtige omgeving ontstaat voor machine learning toepassingen. De desktop-app, MLX Studio, biedt een gebruiksvriendelijke interface voor chatfunctionaliteit, modelbeheer en beeldbewerking, waardoor het toegankelijk is voor zowel ontwikkelaars als eindgebruikers.
Meest gekozen alternatief
De software bevat geavanceerde functies zoals continue batching, prefix caching en meerdere quantisatie-opties, wat de prestaties en efficiëntie verhoogt. Het ondersteunt een breed scala aan modellen, waaronder tekst- en visiemodellen, en biedt ook mogelijkheden voor geluidsbewerking. Met de mogelijkheid om meerdere modellen tegelijkertijd te draaien via een enkele API-gateway, is vMLX een veelzijdige oplossing voor AI-ontwikkeling op macOS.